Publications

* Equal contribution, ✉ Corresponding author

2025

  1. 2025dart.jpg
    Efficient Multi-turn RL for GUI Agents via Decoupled Training and Adaptive Data Curation
    Pengxiang Li , Zechen Hu , Zirui Shang , Jingrong Wu , Yang Liu , Hui Liu , Zhi Gao , Chenrui Shi , Bofei Zhang , Zihao Zhang , Xiaochuan Shi , Zedong YU , Yuwei Wu✉ , Xinxiao Wu , Yunde Jia , Liuyu Xiang , Zhaofeng He , and Qing Li✉
    arXiv preprint arXiv:2509.23866, 2025
  2. 2025tongui.jpg
    TongUI: Building Generalized GUI Agents by Learning from Multimodal Web Tutorials
    Bofei Zhang , Zirui Shang , Zhi Gao , Wang Zhang , Rui Xie , Xiaojian Ma , Tao Yuan , Xinxiao Wu , Song-Chun Zhu , and Qing Li✉
    arXiv preprint arXiv:2504.12679, 2025
  3. 2025sport.jpg
    Iterative Tool Usage Exploration for Multimodal Agents via Step-wise Preference Tuning
    Pengxiang Li* , Zhi Gao* , Bofei Zhang , Yapeng Mi , Xiaojian Ma , Chenrui Shi , Tao Yuan , Yuwei Wu✉ , Yunde Jia , Song-Chun Zhu , and Qing Li✉
    Neural Information Processing Systems (NeurIPS), 2025
  4. 2025anywhere3d.jpg
    From Objects to Anywhere: A Holistic Benchmark for Multi-level Visual Grounding in 3D Scenes
    Tianxu Wang , Zhuofan Zhang , Ziyu Zhu , Yue Fan , Jing Xiong , Pengxiang Li , Xiaojian Ma , and Qing Li✉
    Neural Information Processing Systems: Datasets and Benchmarks (NeurIPS D&B), 2025
  5. 2025nep.jpg
    NEP: Autoregressive Image Editing via Next Editing Token Prediction
    Huimin Wu , Xiaojian Ma , Haozhe Zhao , Yanpeng Zhao , and Qing Li✉
    Neural Information Processing Systems (NeurIPS), 2025
  6. 2025mtu.gif
    Move to Understand a 3D Scene: Bridging Visual Grounding and Exploration for Efficient and Versatile Embodied Navigation Highlight
    Ziyu Zhu , Xilin Wang , Yixuan Li , Zhuofan Zhang , Xiaojian Ma , Yixin Chen , Baoxiong Jia , Wei Liang , Qian Yu , Zhidong Deng✉ , Siyuan Huang✉ , and Qing Li✉
    International Conference on Computer Vision (ICCV), 2025
  7. 2025eva.png
    Embodied VideoAgent: Persistent Memory from Egocentric Videos and Embodied Sensors Enables Dynamic Scene Understanding Highlight
    Yue Fan , Xiaojian Ma , Rongpeng Su , Jun Guo , Rujie Wu , Xi Chen , and Qing Li✉
    International Conference on Computer Vision (ICCV), 2025
  8. Falcon: Fast Visuomotor Policies via Partial Denoising
    Haojun Chen , Minghao Liu , Chengdong Ma , Xiaojian Ma , Zailin Ma , Huimin Wu , Yuanpei Chen , Yifan Zhong , Mingzhi Wang , Qing Li✉ , and Yaodong Yang✉
    International Conference on Machine Learning (ICML), 2025
  9. 2025metascenes.gif
    MetaScenes: Towards Automated Replica Creation for Real-world 3D Scans
    Huangyue Yu , Baoxiong Jia , Yixin Chen , Yandan Yang , Rongpeng Su , Jiaxin Li , Qing Li , Wei Liang , Song-Chun Zhu , Tengyu Liu , and Siyuan Huang
    The IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2025
  10. 2025beacon3d.png
    Unveiling the Mist over 3D Vision-Language Understanding: Object-centric Evaluation with Chain-of-Analysis
    Jiangyong Huang , Baoxiong Jia , Ziyu Zhu , Yan Wang , Xiongkun Linghu , Qing Li , Song-Chun Zhu , and Siyuan Huang
    The IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2025
  11. 2025mat.png
    Multi-modal Agent Tuning: Building a VLM-Driven Agent for Efficient Tool Usage Spotlight
    Zhi Gao* , Bofei Zhang* , Pengxiang Li* , Xiaojian Ma , Tao Yuan , Yue Fan , Yuwei Wu✉ , Yunde Jia , Song-Chun Zhu , and Qing Li✉
    International Conference on Learning Representations (ICLR), 2025
  12. 2025mmke.png
    MMKE-Bench: A Multimodal Editing Benchmark for Diverse Visual Knowledge
    Yuntao Du* , Kailin Jiang* , Zhi Gao , Chenrui Shi , Zilong Zheng✉ , Siyuan Qi , and Qing Li✉
    International Conference on Learning Representations (ICLR), 2025

2024

  1. 2024fire.png
    FIRE: A Dataset for Feedback Integration and Refinement Evaluation of Multimodal Models
    Pengxiang Li* , Zhi Gao* , Bofei Zhang* , Tao Yuan , Yuwei Wu✉ , Mehrtash Harandi , Yunde Jia , Song-Chun Zhu , and Qing Li✉
    Neural Information Processing Systems: Datasets and Benchmarks (NeurIPS D&B), 2024
  2. 2024ultraedit.png
    UltraEdit: Instruction-based Fine-Grained Image Editing at Scale
    Haozhe Zhao* , Xiaojian Ma* , Liang Chen , Shuzheng Si , Rujie Wu , Kaikai An , Peiyu Yu , Minjia Zhang , Qing Li✉ , and Baobao Chang✉
    Neural Information Processing Systems: Datasets and Benchmarks (NeurIPS D&B), 2024
  3. 2024omnijarvis.png
    OmniJARVIS: Unified Vision-Language-Action Tokenization Enables Open-World Instruction Following Agents
    Zihao Wang , Shaofei Cai , Zhancun Mu , Haowei Lin , Ceyao Zhang , Xuejie Liu , Qing Li , Anji Liu , Xiaojian Ma , and Yitao Liang
    Neural Information Processing Systems (NeurIPS), 2024
  4. 2024sg3d.png
    Task-oriented Sequential Grounding in 3D Scenes
    Zhuofan Zhang , Ziyu Zhu , Pengxiang Li , Tengyu Liu , Xiaojian Ma , Yixin Chen , Baoxiong Jia , Siyuan Huang , and Qing Li✉
    arXiv preprint arXiv:2408.04034, 2024
  5. luo2024insight.png
    End-to-End Neuro-Symbolic Reinforcement Learning with Textual Explanations Spotlight (top 3.5%)
    Lirui Luo , Guoxi Zhang , Hongming Xu , Yaodong Yang , Cong Fang✉ , and Qing Li✉
    International Conference on Machine Learning (ICML), 2024
  6. zhu2024unifying.png
    Unifying 3D Vision-Language Understanding Via Promptable Queries
    Ziyu Zhu , Zhuofan Zhang , Xiaojian Ma , Xuesong Niu , Yixin Chen , Baoxiong Jia , Zhidong Deng✉ , Siyuan Huang✉ , and Qing Li✉
    European Conference on Computer Vision (ECCV), 2024
  7. fan2024videoagent.png
    VideoAgent: A Memory-augmented Multimodal Agent for Video Understanding
    Yue Fan* , Xiaojian Ma* , Rujie Wu , Yuntao Du , Jiaqi Li , Zhi Gao , and Qing Li✉
    European Conference on Computer Vision (ECCV), 2024
  8. guo2024semantic.png
    Semantic Gaussians: Open-Vocabulary Scene Understanding with 3D Gaussian Splatting
    Jun Guo* , Xiaojian Ma* , Yue Fan , Huaping Liu✉ , and Qing Li✉
    arXiv preprint arXiv:2403.15624, 2024
  9. xin2024parameter.png
    Parameter-Efficient Fine-Tuning for Pre-Trained Vision Models: A Survey
    Yi Xin , Siqi Luo , Haodi Zhou , Junlong Du , Xiaohong Liu , Yue Fan , Qing Li , and Yuntao Du
    arXiv preprint arXiv:2402.02242, 2024
  10. jia2024sceneverse.png
    SceneVerse: Scaling 3D Vision-Language Learning for Grounded Scene Understanding
    Baoxiong Jia* , Yixin Chen* , Huangyue Yu , Yan Wang , Xuesong Niu , Tengyu Liu , Qing Li , and Siyuan Huang
    European Conference on Computer Vision (ECCV), 2024
  11. gao2024clova.png
    CLOVA: A Closed-Loop Visual Assistant with Tool Usage and Update
    Zhi Gao , Yuntao Du , Xintong Zhang , Xiaojian Ma , Wenjuan Han , Song-Chun Zhu , and Qing Li✉
    The IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2024
  12. huang2024embodied.png
    An Embodied Generalist Agent in 3D World
    Jiangyong Huang* , Silong Yong* , Xiaojian Ma* , Xiongkun Linghu* , Puhao Li , Yan Wang , Qing Li , Song-Chun Zhu , Baoxiong Jia , and Siyuan Huang
    International Conference on Machine Learning (ICML), 2024
  13. li2024nsr.png
    Neural-Symbolic Recursive Machine for Systematic Generalization
    International Conference on Learning Representations (ICLR), 2024
  14. wu2024bongard.png
    Bongard-OpenWorld: Few-Shot Reasoning for Free-Form Visual Concepts in the Real World
    Rujie Wu* , Xiaojian Ma* , Zhenliang Zhang , Wei Wang✉ , Qing Li✉ , Song-Chun Zhu , and Yizhou Wang
    International Conference on Learning Representations (ICLR), 2024

2023

  1. qin2023learning.png
    Learning Non-Markovian Decision-Making from State-Only Sequences
    Aoyang Qin , Feng Gao , Qing Li , Song-Chun Zhu , and Sirui Xie
    Neural Information Processing Systems (NeurIPS), 2023
  2. li2023hint.png
    A Minimalist Dataset for Systematic Generalization of Perception, Syntax, and Semantics Notable-top-25%
    International Conference on Learning Representations (ICLR), 2023
  3. zhu2023vista.png
    3D-VisTA: Pre-Trained Transformer for 3D Vision and Text Alignment
    Ziyu Zhu , Xiaojian Ma , Yixin Chen , Zhidong Deng✉ , Siyuan Huang✉ , and Qing Li✉
    International Conference on Computer Vision (ICCV), 2023
  4. ma2023sqa3d.png
    SQA3D: Situated Question Answering in 3D Scenes
    International Conference on Learning Representations (ICLR), 2023

2022

  1. Close the Loop of Neural Perception, Grammar Parsing, and Symbolic Reasoning
    Qing Li
    University of California, Los Angeles, 2022

2021

  1. li2021unified.png
    Towards a Unified Foundation Model: Jointly Pre-Training Transformers on Unpaired Images and Text
    Qing Li , Boqing Gong , Yin Cui , Dan Kondratyuk , Xianzhi Du , Ming-Hsuan Yang , and Matthew Brown
    arXiv preprint arXiv:2112.07074, 2021
  2. hong2021smart.png
    SMART: A Situation Model for Algebra Story Problems via Attributed Grammar
    Yining Hong , Qing Li , Ran Gong , Daniel Ciao , Siyuan Huang , and Song-Chun Zhu
    AAAI Conference on Artificial Intelligence (AAAI), 2021
  3. hong2021learning.png
    Learning by Fixing: Solving Math Word Problems with Weak Supervision
    Yining Hong , Qing Li , Daniel Ciao , Siyuan Huang , and Song-Chun Zhu
    AAAI Conference on Artificial Intelligence (AAAI), 2021
  4. chen2021yourefit.png
    YouRefIt: Embodied Reference Understanding with Language and Gesture Oral
    Yixin Chen , Qing Li , Deqian Kong , Yik Lun Kei , Song-Chun Zhu , Tao Gao , Yixin Zhu , and Siyuan Huang
    International Conference on Computer Vision (ICCV), 2021
  5. hong2021vlgrammar.png
    VLGrammar: Grounded Grammar Induction of Vision and Language
    Yining Hong , Qing Li , Song-Chun Zhu , and Siyuan Huang
    International Conference on Computer Vision (ICCV), 2021

2020

  1. li2020competence.png
    A Competence-Aware Curriculum for Visual Concepts Learning Via Question Answering Oral
    Qing Li , Siyuan Huang , Yining Hong , and Song-Chun Zhu
    European Conference on Computer Vision (ECCV), 2020
  2. li2020ngs.png
    Closed Loop Neural-Symbolic Learning Via Integrating Neural Perception, Grammar Parsing, and Symbolic Reasoning Best Paper in ICML Workshop
    International Conference on Machine Learning (ICML), 2020

2019

  1. bhattacharya2019visual.png
    Why Does a Visual Question Have Different Answers?
    Nilavra Bhattacharya , Qing Li , and Danna Gurari
    International Conference on Computer Vision (ICCV), 2019
  2. gurari2019vizwizpriv.png
    VizWiz-Priv: A Dataset for Recognizing the Presence and Purpose of Private Visual Information in Images Taken by Blind People
    Danna Gurari , Qing Li , Chi Lin , Yinan Zhao , Anhong Guo , Abigale Stangl , and Jeffrey P Bigham
    The IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2019

2018

  1. li2018tell.png
    Tell-and-Answer: Towards Explainable Visual Question Answering Using Attributes and Captions Oral
    Qing Li , Jianlong Fu , Dongfei Yu , Tao Mei , and Jiebo Luo
    Annual Conference on Empirical Methods in Natural Language Processing (EMNLP), 2018
  2. li2018vqa.png
    VQA-E: Explaining, Elaborating, and Enhancing Your Answers for Visual Questions
    Qing Li , Qingyi Tao , Shafiq Joty , Jianfei Cai , and Jiebo Luo
    European Conference on Computer Vision (ECCV), 2018
  3. gurari2018vizwiz.png
    VizWiz Grand Challenge: Answering Visual Questions from Blind People Spotlight
    Danna Gurari , Qing Li , Abigale J Stangl , Anhong Guo , Chi Lin , Kristen Grauman , Jiebo Luo , and Jeffrey P Bigham
    The IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 2018

2017

  1. li2017learning.png
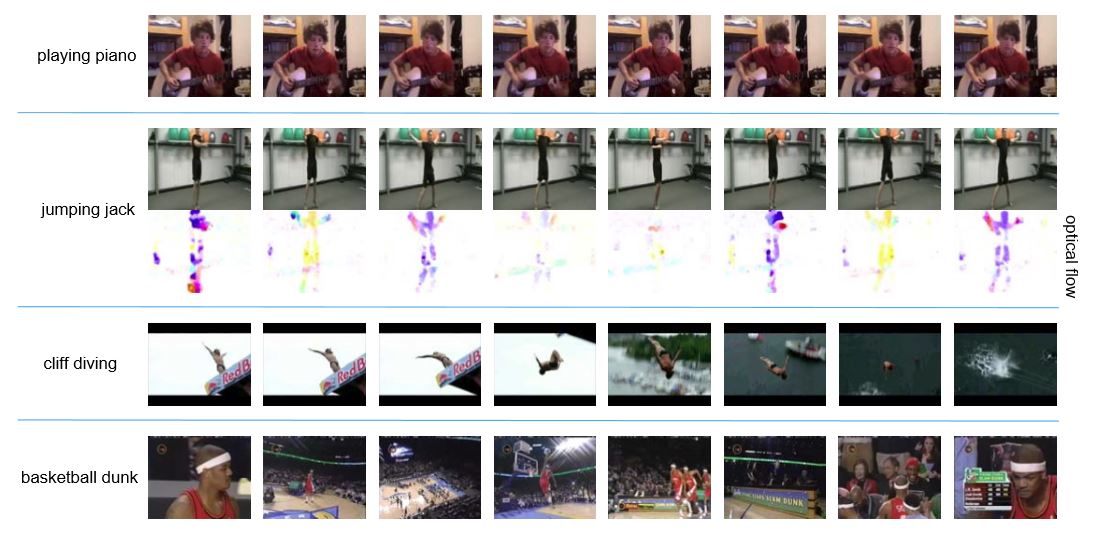
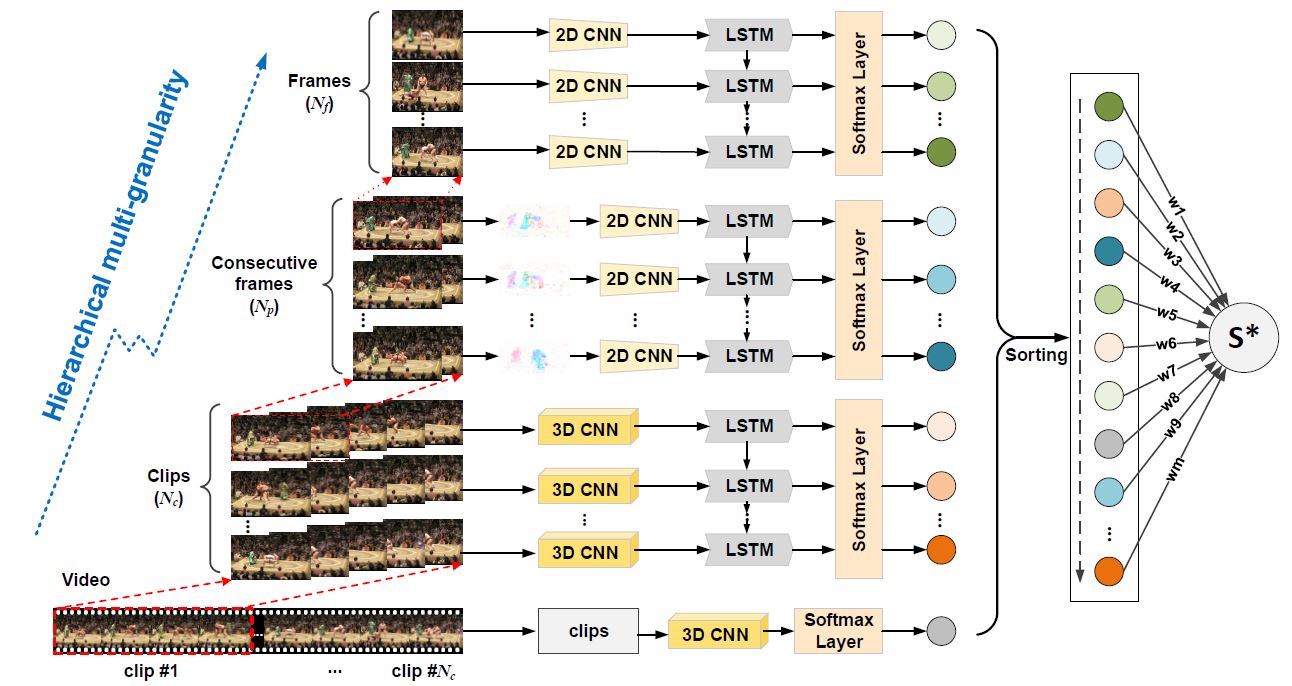
    Learning Hierarchical Video Representation for Action Recognition
    Qing Li , Zhaofan Qiu , Ting Yao , Tao Mei , Yong Rui , and Jiebo Luo
    International Journal of Multimedia Information Retrieval, 2017

2016

  1. li2016action.png
    Action Recognition by Learning Deep Multi-Granular Spatio-Temporal Video Representation Best Paper Finalist
    Qing Li , Zhaofan Qiu , Ting Yao , Tao Mei , Yong Rui , and Jiebo Luo
    International Conference on Multimedia Retrieval, 2016